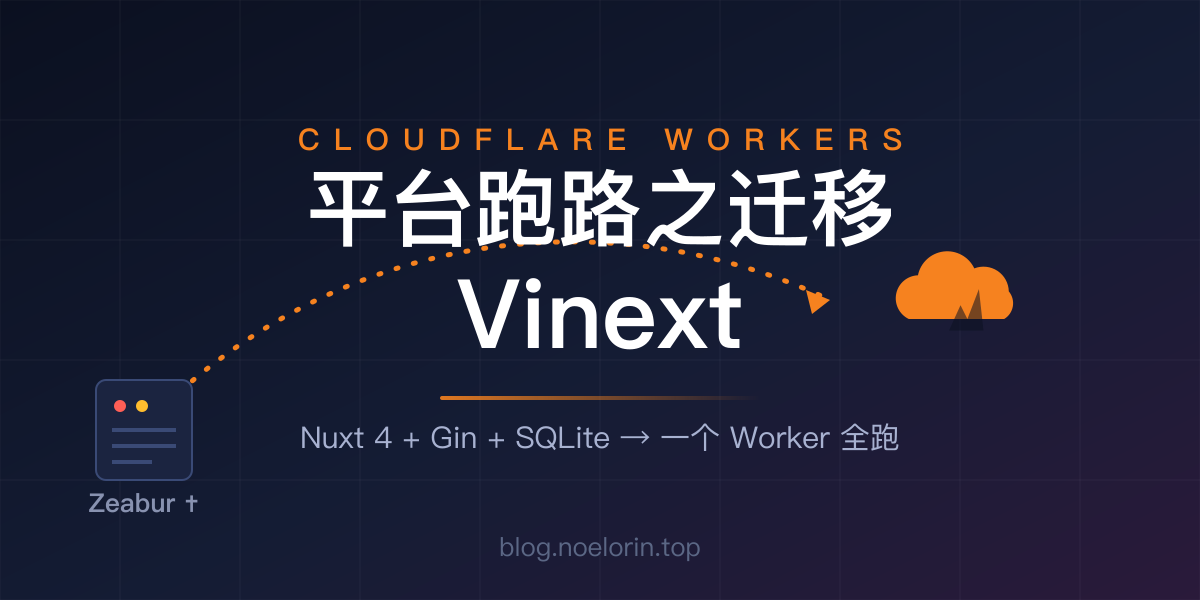
平台跑路之迁移Vinext
10月下旬Zeabur 发邮件说服务要停了....
缘起
某天 Zeabur 发邮件说服务要停了,主包博客正好跑在上面。老架构是两个容器,Nuxt 4 + Gin + SQLite 。
为什么是 Workers
新家没怎么纠结。手上还有个美西的VPS也挂在zeabur上了,而且考虑到延迟和线路的问题,整下来太麻烦了。Cloudflare 那边一个 Worker 就能跑。
老架构搬不过去
先说清楚,换技术栈不是主包喜新厌旧,是被平台逼的。
Workers 里没有常驻进程,每个请求起一个 isolate,跑完就没了,Nuxt 和 Go 这两个常驻服务天生没地方待,根本跑不起来。Workers 没有文件系统,fs、path、better-sqlite3 全在禁用名单上。
所以老栈原样搬过来是死路,只能重写。之前看到Cloudflare用AI复刻NEXT.js整了个Vinext,能在 Workers 上跑 Next.js 的 vinext,本质是 Next.js 加 Vite 的实现,不是 Nuxt 的替代品。也就是说选 Workers 的那一刻,等于顺手决定了整站要用 React 重写一遍。
搬家
后端 43 条 JSON API 里,除了根路径那条,剩下 42 条全用 TypeScript 重写,跟前端塞进同一个 Worker。原来挂在上面的两条 SPA 静态路由,被应用内后台直接顶掉了。以前要走一次内网请求的调用,现在就是个函数调用,SSR 的时候直接读数据库。保证新老一致的办法是让AI对着GIN后端录基线然后完全复刻。
踩的坑
坑里最狠的一个是密码。后台密码从 bcrypt 换成 PBKDF2-SHA256,按惯例写了 21 万次迭代,本地测试全绿,部署上去所有账号都登不进去。查了半天才看到 workerd 的原话:NotSupportedError: Pbkdf2 failed: iteration counts above 100000 are not supported (requested 210000).,cpu时间直接干超时了
第二个是每个 POST 全挂,单测还是全绿。vinext 塞给路由的不是浏览器那个真 Request,是个套了一层的包装对象,new Request(request, { body }) 一碰就把它当 URL 解析,报 TypeError: Invalid URL: [object Request]。
顺手干的活
后台借这次重写整个换了。密码改成 PBKDF2 存,登录加了 TOTP 两步验证,密码过了先给一个五分钟的一次性挑战,最多错五次,验证器过了才发会话。动机很朴素,就是不想哪天密码被撞了连个响都没有。
管理员账号改成部署的时候从构建变量引导进去,运行时不再留恢复后门。之前那版恢复登录,因为声明了 secret 绑定但面板里没配,cf deploy 直接报 required secrets have not been set 失败,索性整个退役了。
备份这块得实话实说。旧站那个每天一点的备份救了这次,新站反而还没补上。Worker 的 cron 现在每小时只干两件事,清过期的 Session 和登录挑战,没有导出。
总结
大要不是平台跑路,主包大概很长一阵子不会动这套跑得好好的老栈。现在部署就一个 Worker,不用管服务器,现在白嫖先,实在不行,一个月顶多五刀。